Vocea ta e de ajuns.
Unii oameni știu exact ce vor să spună, dar cei din jur nu îi înțeleg.
Grai ajută persoanele cu dificultăți de vorbire să comunice mai ușor și mai natural, folosind modele AI personalizate.
- Ascultă
- Citește buzele
- Rostește clar
Ești la expoziția DPIT 2026? Vino la standul Grai și vezi aplicația live.
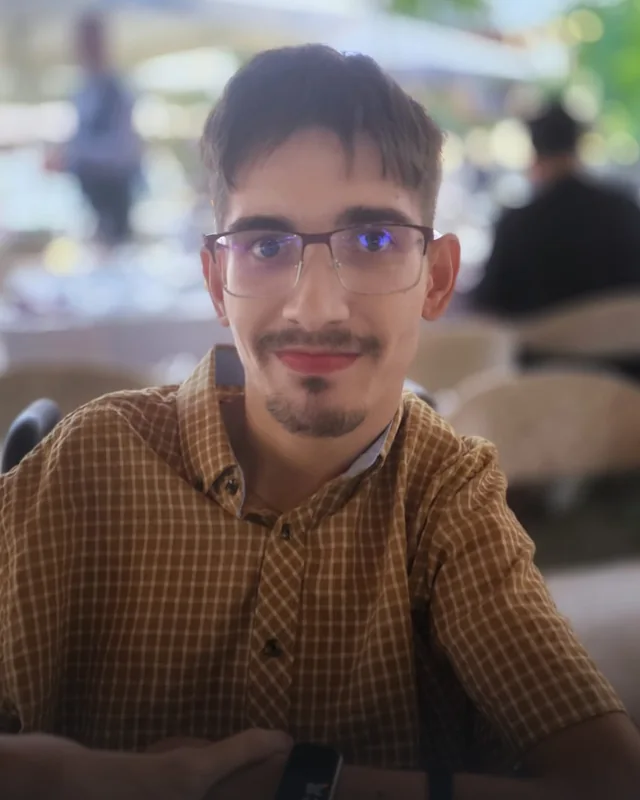
Știe ce vrea să spună. Nu este înțeles.
Tudor e din Oradea și lucrează în IT. Știe exact ce vrea să spună, dar mușchii vorbirii nu îl ascultă. Asta se numește dizartrie.
În dizartrie, mesajul se formează clar în minte, dar mușchii buzelor, ai limbii și ai corzilor vocale nu îl mai pot rosti limpede. Cei din jur înțeleg greu cuvintele, iar o conversație obișnuită devine un efort pentru ambele părți.
Cauze frecvente
- accidentul vascular cerebral (AVC)
- boala Parkinson
- scleroza laterală amiotrofică (ALS)
- scleroza multiplă
Câți oameni trăiesc cu dizartrie
83.075cazuri noi de boli cerebrovasculare în România, într-un singur an (2023)
până la 58%dintre cei care fac un AVC au dizartrie
- ≈ 3,2 mil.împreună cu restul Europei
- ≈ 1,5 mil.împreună cu vorbitorii de engleză
- 67.500în România
Surse: Ministerul Sănătății / INSP (2023), ASHA. Estimările sunt calculate de noi pe baza datelor publicate de Agerpres, CDC, Stroke Association, SAFE și alte surse.
Cum funcționează
Grai folosește doar camera și microfonul telefonului. Persoana vorbește, iar aplicația transformă ce a spus într-o voce clară, prin patru pași.
-
Captează
Persoana apasă o dată pe microfon, iar telefonul trimite sunetul și imaginea feței către server. Între propoziții nu mai trebuie apăsat nimic: o pauză scurtă îi arată aplicației că propoziția s-a încheiat.
-
Înțelege
Un model transformă vorbirea în text și propune până la cinci variante. Un al doilea model recunoaște fraza din mișcarea buzelor și a feței.
-
Verifică
Fuziunea compară cele două rezultate. Dacă imaginea arată sigur o altă frază dintre cele auzite, aplicația întreabă: „Ai vrut să spui…?”
-
Rostește
Textul apare pe ecran, iar o voce sintetizată îl rostește clar, în limba română.
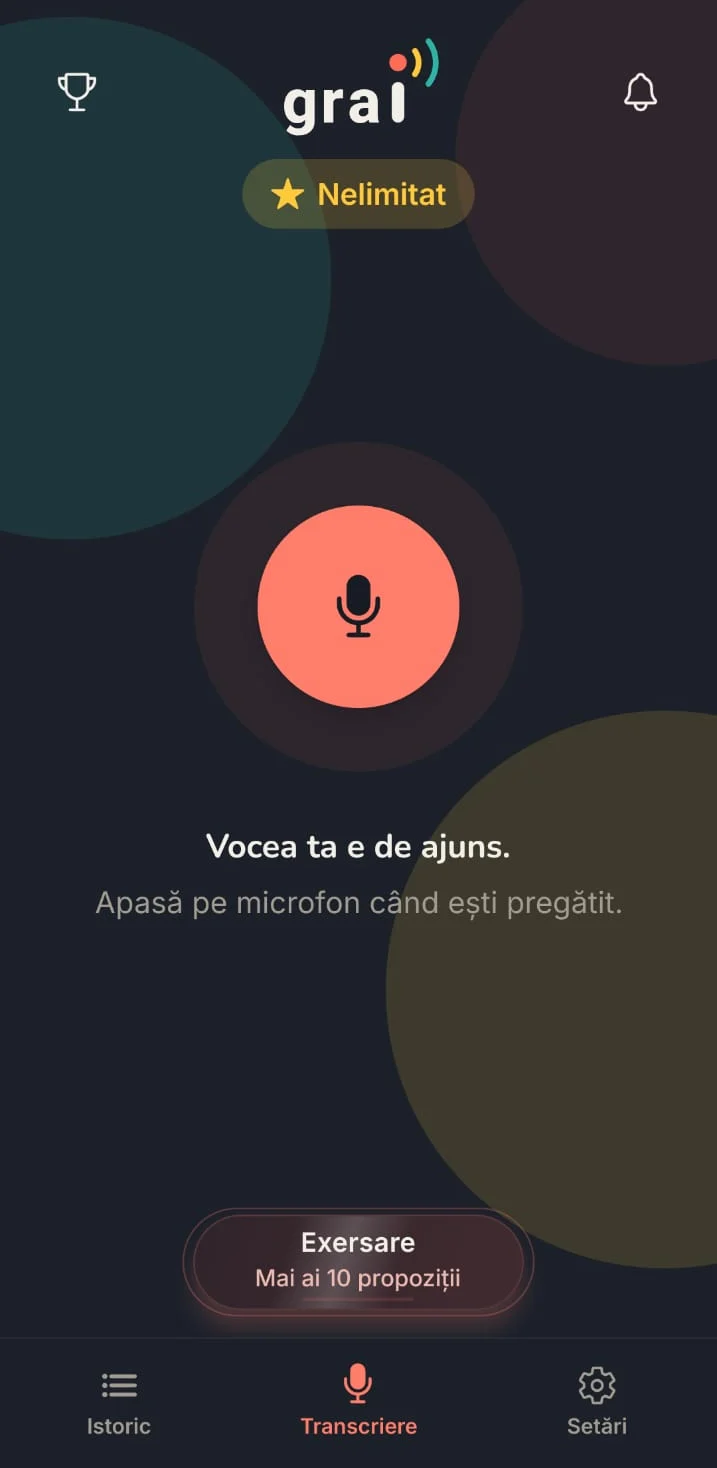
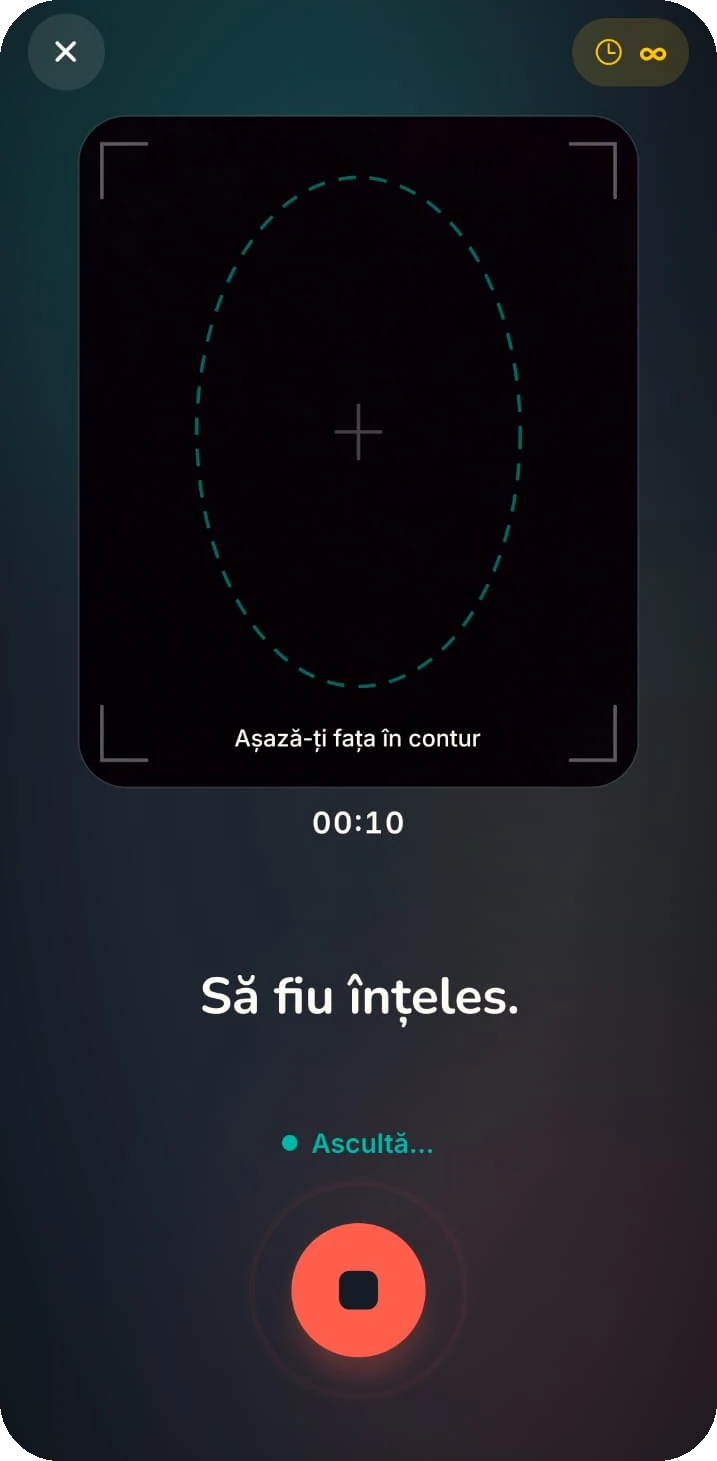
≈ 1,3 secunde trec, de obicei, de la ultimul cuvânt până la vocea sintetizată. Din acest timp, 0,9 secunde sunt pauza după care aplicația știe că propoziția s-a terminat.
- Conversațiile nu se înregistrează. Sunetul și imaginea sunt procesate în memorie și nu se salvează.
- Textul rămâne doar dacă vrei. O conversație se păstrează numai dacă alegi să o salvezi.
- Grai nu inventează. Afișează exact ce a auzit sau, dacă recunoaște una dintre frazele învățate, forma ei corectă.
Tehnologia din spate
Peste 900 de teste automate
Aplicația de pe telefon comunică cu un server pe care rulează modelele de inteligență artificială. Schema arată drumul unei propoziții, de la microfon până la vocea sintetizată.
Audio decide, video verifică
Vocea pornește imediat, pe baza textului auzit. Modelul video confirmă rezultatul sau, doar atunci când este sigur, propune o altă variantă dintre cele auzite.
De ce Wav2Vec2 și nu Whisper
Whisper scrie fluent, dar poate produce o propoziție pe care omul nu a rostit-o. Într-o aplicație care vorbește în numele cuiva, un text inventat este mai grav decât o greșeală vizibilă.
Poarta buzelor
Dacă fața se vede clar, dar gura nu s-a mișcat, propoziția aparține altcuiva din încăpere și nu este rostită.
De ce un server
Modelul audio are aproximativ 1,2 GB, prea mult pentru un telefon. Modelele rulează pe un calculator cu placă video, iar telefonul se conectează la el printr-o legătură criptată.
Rezultate
Am testat modelele pe 160 de rostiri ale lui Tudor pe care nu le auziseră la antrenare: ultimele două repetări ale fiecăreia dintre cele 80 de fraze.
- 26,05%Modelul de pornire
- 85,6%Antrenat pe vocea lui Tudor
- 92,33%+ model de limbă
- 93,72%+ cele 80 de fraze
Modelul de limbă alege cuvintele care formează o frază corectă în română. În ultimul pas, cele 80 de fraze învățate sunt favorizate, dar aplicația poate scrie și cuvinte noi.
144 din 160de fraze au fost recunoscute corect doar din mișcarea buzelor, fără sunet.
71%dintre frazele de test au fost confirmate de fuziune, fără niciun dezacord între sunet și imagine (106 din 150).
„Aplicația mi se pare utilă și cred că va fi așa pentru mulți oameni, având un impact real.”
Toate rezultatele sunt obținute pe o singură voce, a lui Tudor. Ca Grai să funcționeze și pentru alți oameni, urmează etapa de personalizare: aplicația va învăța vorbirea fiecărui utilizator nou.
De la idee la aplicație
Până acum
- iunieIdeeaAm observat că nu există o aplicație în română pentru vorbirea dizartrică.
- iuliePlanulAm stabilit ce trebuie să conțină prima versiune a aplicației.
- 5 augustCentroKineticNe-am întâlnit cu echipa CentroKinetic și am validat ideea și nevoia reală pentru o astfel de aplicație.
- 28 august800 de înregistrăriTudor a rostit 80 de fraze, fiecare de câte zece ori, cu sunet și imagine.
- septembrieModelele AIAm antrenat modelele pentru voce și pentru mișcarea buzelor.
- octombriePrima versiune funcționalăAplicația recunoaște vorbirea lui Tudor și o rostește clar, pe telefon.
Ce urmează
- Idee, date și prima versiune2026
- 4Follow-up cu CentroKineticfinal 2026Vedem dacă interesul pentru Grai se menține și cum putem colabora mai departe.
- 5Personalizareînceput 2027Aplicația învață singură vorbirea fiecărui utilizator nou.
- 6Lansareprimăvara 2027Grai devine disponibil în România.
- 7ViziuneVocea ta2027–2028Grai vorbește cu vocea omului, păstrată din înregistrările lui.
- 8Alte limbi2028Întâi engleza, apoi restul Europei.
Echipa
Suntem șase elevi pasionați de software și hardware. Am construit Grai în programul DPIT 2026 – Descoperă Pasiunea în IT, cu sprijinul mentorilor de la Wolfpack Digital.
 Greab DavidBackend & QA
 Mocan RaulAI Team Lead & Computer Vision
 Geapana AlexIntegration, Machine Learning & Speech AI
 Chiriac AlexiaMarketing & Media, Backend
 Popa DavidFull-Stack Developer
 Muntean MariaFrontend & UI/UX Design
Mulțumiri
Tudor
Tudor ne-a oferit 800 de înregistrări: 80 de fraze, fiecare rostită de zece ori. Datorită lui, modelele Grai au învățat din vorbire dizartrică reală, nu dintr-una simulată.
Echipa Wolfpack Digital ne-a fost mentor pe tot parcursul programului DPIT 2026.
Contactează-ne
Pentru întrebări despre aplicație, propuneri de colaborare sau dacă vrei să testezi Grai, ne poți scrie pe e-mail, pe Instagram sau pe Facebook.